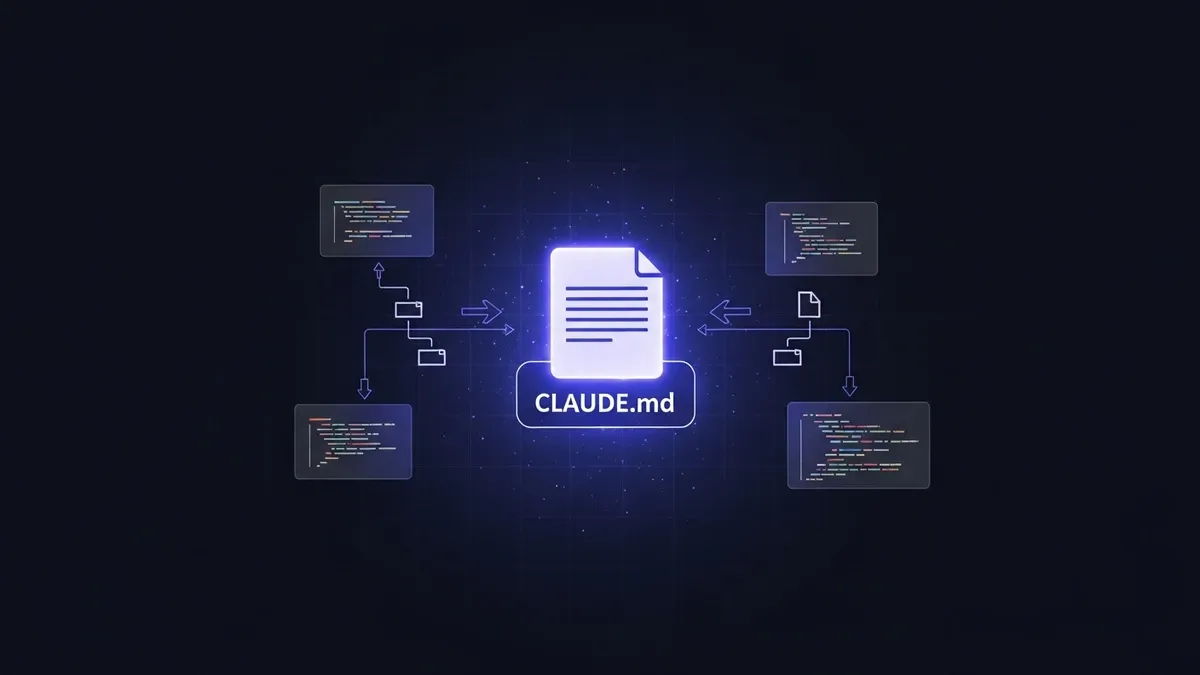
Claude Codeに同じ説明を繰り返しているなら、毎回必要なルールをCLAUDE.mdへまとめる方法があります。長い説明書を作るより、作業に必要な数項目から始めましょう。
情報
- CLAUDE.mdは、人が書く継続的な指示。自動メモリとは別の仕組み
- ビルド方法やディレクトリの役割など、繰り返し必要な情報を書く
- 指示書は強制的なアクセス制御ではなく、秘密を置く場所でもない
2026年10月13日にClaude Code公式のメモリ説明を再確認しました。ここでは個人や小さなチームが、最初の指示書を整える流れを扱います。
「記憶できないから必要」だけでは説明が足りない
現在のClaude Codeには、人が記述するCLAUDE.mdと、Claudeが学びを記録する自動メモリがあります。前回の会話をすべて同じ形で持ち続けることとは区別します。
CLAUDE.mdには、プロジェクトの方針や毎回守ってほしい約束を書きます。自動メモリがあるからといって、チームで決めたルールの記述が不要になるわけではありません。
| 情報 | 置く場所の考え方 |
|---|---|
| 全員が使うビルド手順 | プロジェクトの指示書 |
| 自分の文章や作業の好み | ユーザーの指示書 |
| 今回だけの修正内容 | 今回の依頼や作業メモ |
| APIキー・パスワード | 指示書には書かない |
ファイルを増やす前に、同じ情報をREADMEや既存の指示書に重複して書いていないか確認します。複数の場所を別々に直す運用は、矛盾を生みやすくなります。
最初はプロジェクト直下に、一枚だけ
共同作業のルールなら、プロジェクト直下のCLAUDE.mdが分かりやすい出発点です。個人設定を共有ファイルへ混ぜないようにします。
# このプロジェクトの進め方
- 起動・テストのコマンドは README.md の開発手順を確認する
- 既存の命名規則とファイル配置に合わせる
- 変更後は、実行した確認と未確認の項目を報告する
これは書き方の例です。そのまま貼るのではなく、実際のプロジェクトで正しいコマンドやルールへ置き換えてください。
-
繰り返している説明を集める
最近の作業で何度も訂正した点を、少数の項目にします。
-
実際のコードやREADMEと照合する
存在しないテストや古い構成を、指示書へ残さないようにします。
-
小さな作業で読み込みを確認する
ルールを参照したかと、実際の変更が合っているかを両方確認します。
公式には、たたき台を作る /init と、読み込まれたメモリを確認する /context の案内があります。生成された内容も人が確認してから使います。
個人用と共有用を分ける
誰に適用するかを決めると、配置場所を選びやすくなります。
| 配置 | 主な用途 |
|---|---|
~/.claude/CLAUDE.md | 自分の各プロジェクト |
./CLAUDE.md | チームで共有するルール |
./CLAUDE.local.md | このプロジェクトの個人設定 |
ローカル個人用ファイルはGit管理から外します。ただし、Gitに入らないことと、AIに読まれないことは違います。認証情報や個人情報の保管先にはしません。
注意
CLAUDE.mdは設定による権限制御ではありません。「本番へ変更しない」と書くだけに頼らず、実際の権限や実行環境でも制限する必要があります。
組織全体で管理する指示書もありますが、個人が思いつきで変更するものではありません。会社の環境では、既存の管理方針を先に確認してください。
長くなったら、足す前に整理する
「短くする」は必要なルールを捨てることではありません。重複、古い内容、今回限りの作業記録を取り除くことから始めます。
たとえば「品質を高く」は確認できません。「変更した処理に対応するテスト結果を報告する」なら、結果を見て確認できます。具体的な行動に直すと役割が明確になります。
- 実行できる手順になっているか
- 別の指示書と矛盾していないか
- 今回限りのメモを混ぜていないか
- 新しい参加者にも必要な内容か
特定ディレクトリだけの約束は、その範囲のルールに分ける方法もあります。読み込み対象が変わるため、移した後にはもう一度確認しましょう。
インポートは、無料で情報を増やす仕組みではない
@path で別のファイルを参照するインポートは、整理には便利です。ただし読み込まれる情報が増えれば、その分コンテキストも使います。
指示書と資料を増やすと、残りの領域がどう変わるかを試せます。下の上限と内訳は架空の数値です。実際のモデル上限、課金、週間利用枠とは別で、実際の状態は /context で確認してください。
コンテキストの内訳を動かしてみる
上限16,000トークンを含め、すべて架空の練習用数値です。実際のモデル上限や料金・利用枠を示しません。
予算線:16,000 tokens
図の右端:16,000 tokens。超過時は図を広げ、予算線を内側に表示します。
- 指示
- 1,000 tokens
- 会話履歴
- 4,000 tokens
- ツール・ファイル
- 3,000 tokens
- 出力の予約
- 2,000 tokens
- 残り
- 6,000 tokens
- 予算超過
- 0 tokens
図と初期値はこのまま読めます。表示範囲に入ると操作を準備します。
全体 16,000 tokens に対し、予約を含む配分は 10,000 tokens。残りは 6,000 tokens、予算超過はありません。
計算の前提と、結果の読み方
- 初期値は操作説明のための架空例です。特定モデルの上限や実際のAPI消費量を示しません。
- すべてtokens単位の明示入力です。文字数からの換算やモデル仕様の推定は行いません。
- 出力の予約は未使用でも予算から差し引きます。実際のサービスの制約や計数方法とは異なる場合があります。
あわせて読みたい
コンテキストを整理する:圧縮とリセットの使い分け
指示書も、プロジェクトと一緒に手入れする
ビルド方法や配置を変えたら、指示書も同時に直します。守られなかった場合は文章を長くする前に、読み込まれていたか、矛盾がないかを確認してください。
- 最初は毎回必要な数項目に絞る
- 個人用とチーム共有を分ける
- 読み込みと実際の結果を確認する
- 権限制御や秘密管理の代わりにしない
更新メモ:自動メモリを無視した説明、管理指示書の強制力の断定、秘匿情報をローカル指示書に置く推奨を見直しました。